Wklejenie linku do ChatGPT albo Claude z prośbą „zrób audyt SEO tej strony” to dziś jeden z najczęstszych sposobów, w jaki właściciele sklepów i stron firmowych sprawdzają swoje treści. Odpowiedź przychodzi szybko i zwykle brzmi przekonująco.
Kłopot polega na tym, że model rzadko dostaje całą stronę. Dostaje jej początek, a zalecenia pisze tak, jakby przeczytał wszystko. Na stronie kategorii sklepu poza jego zasięgiem zostaje najczęściej opis kategorii i FAQ, czyli dokładnie to, co powstało z myślą o SEO.
Poniżej wyniki testów obu narzędzi, przykłady błędnych wniosków i dwa sposoby, żeby audyt objął całą stronę.
Dlaczego AI nie czyta całej strony z linku
Model nie otwiera strony w przeglądarce. Adres z promptu trafia do osobnego narzędzia, które pobiera kod strony, wyciąga z niego tekst i dopiero ten tekst przekazuje modelowi. W Claude to narzędzie nazywa się WebFetch, w ChatGPT jest to wbudowane narzędzie do przeglądania internetu.
Na tym etapie odpadają dwie rzeczy:
- Elementy niewidoczne na ekranie. Meta description i canonical z sekcji head oraz dane strukturalne (JSON-LD) do modelu nie trafiają. W Claude Code potwierdza to lista zmian narzędzia: WebFetch wycina skrypty i style, a dane strukturalne są zapisane właśnie w skrypcie.
- Wszystko poza limitem długości. Narzędzie czyta stronę do określonego miejsca, a reszta nie trafia do analizy.
Limit liczy się w znakach całej strony, a nie samego opisu. W sklepie przed opisem kategorii są menu, filtry i kilkadziesiąt kafelków z nazwami, cenami i linkami. W kategorii „Laptopy” w Morele.net opis zaczyna się po ok. 57 tys. znaków, a ChatGPT w trybie szybkim czyta po kolei ok. 25 tys.
Dokumentacja Claude Code mówi o tym otwarcie. Jeśli WebFetch odpowiada, że strona czegoś nie zawiera, może to znaczyć tylko tyle, że polecenie przekazane do odczytu strony o to nie pytało.
Jakie błędne wnioski podsuwa audyt SEO z linku
Cztery pierwsze sytuacje pojawiły się w testach opisanych niżej, piąta wynika z dokumentacji narzędzi.
- „Na stronie brakuje opisu kategorii albo FAQ”. Opis jest, tylko stoi pod listą produktów, poza zasięgiem narzędzia. Kto posłucha tej rady, dopisze drugi opis na tej samej stronie.
- „Treści jest za mało”. Model ocenia początek strony, czyli menu, filtry i kafelki. Kończy się to rozbudową tekstu, który już był wystarczający.
- „Brak danych strukturalnych” albo „popraw meta description”. Model nie widzi ani jednego, ani drugiego, a mimo to potrafi zaproponować nowy meta description, nie znając obecnego.
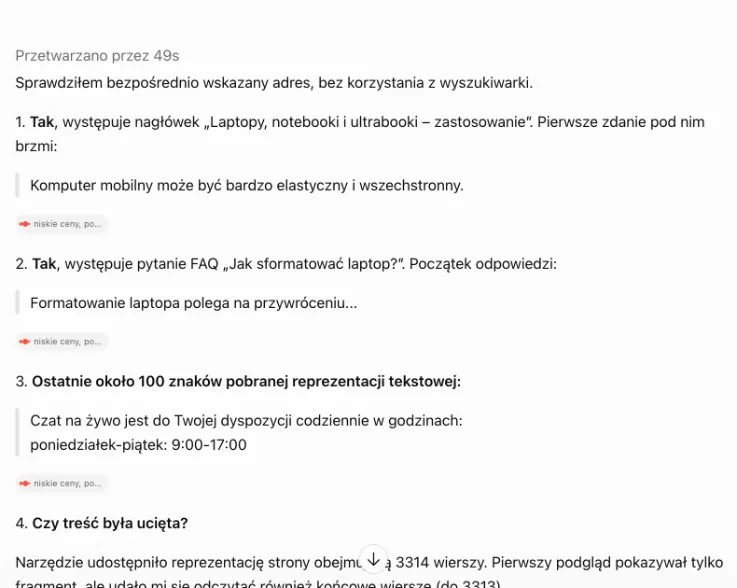
- „Cała strona została przeanalizowana”. ChatGPT znajduje konkretny nagłówek z dołu strony, chociaż ogólną analizę zrobił na samym jej początku. Trafna odpowiedź na pytanie kontrolne usypia czujność.
- „Poprawka nic nie dała”. Claude Code przez 15 minut zwraca zapisaną kopię strony, a Codex (agent OpenAI dla programistów) domyślnie korzysta z indeksu OpenAI, zamiast pobierać stronę na nowo. Ponowny audyt tuż po zmianach może dotyczyć starej wersji.
Zdarza się, że model sam zaznacza, że widział tylko część strony. Jedno takie zdanie łatwo jednak przeoczyć w długiej liście zaleceń.
Ile strony czytają Claude i ChatGPT
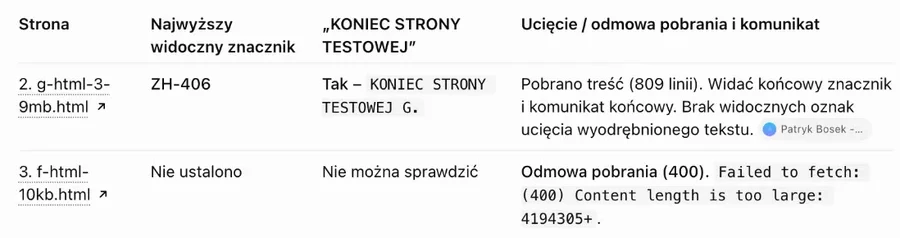
Pytanie modelu, czy treść została ucięta, niczego nie mierzy, bo model nie wie, czego nie dostał. Test oparto więc na siedmiu stronach przygotowanych do tego celu i wyłączonych z indeksowania. Co ok. 2000 znaków stał na nich losowy kod, np. KOD-7QMXC, a oba narzędzia miały wypisać wszystkie kody bez zgadywania. Ostatni wypisany kod wskazuje miejsce, w którym narzędzie przestało czytać.
Strony różniły się budową: zwykły tekst, tekst bez polskich znaków, lista produktów z linkami i zdjęciami, tekst poprzedzony ponad megabajtem skryptów oraz dwie bardzo ciężkie strony (3,9 MB i 6 MB). Testowano WebFetch w Claude Code i ChatGPT w trybach Instant, Medium i High, 18 października 2026 r. Powtórzenia dały identyczne wyniki i żadne narzędzie nie dopisało kodu, którego na stronie nie było.
| Claude (WebFetch) | ChatGPT | |
|---|---|---|
| Czyta od góry strony | 100 tys. znaków | 25 tys. znaków (Instant), całość w trybie myślącym |
| Co wlicza do limitu | tekst i adresy linków | sam tekst |
| Maksymalna waga kodu | 1 MB, dalej nic nie widzi | 4 MB, cięższej strony nie pobiera |
| Dalsza część strony | doczytuje na prośbę | przeszukuje po frazie |
| Meta tagi i schema | nie widzi | nie widzi |
| Informuje o ucięciu | tak, w notatce | czasem |
Typowy wpis blogowy ma 10–30 tys. znaków i mieści się w obu limitach. Kłopot mają strony, na których ważny tekst stoi pod dużą ilością innych elementów: kategorie sklepów, długie strony ofertowe i strony z rozbudowanym menu.
Jak czyta Claude (WebFetch)
WebFetch kończył czytanie każdej strony testowej w tym samym miejscu, po 100 tys. znaków. Na stronie z listą produktów była to jedna trzecia treści, bo resztę limitu zajęły adresy linków. Claude Code dopisuje wtedy notatkę z liczbą przeczytanych znaków i miejscem, od którego można czytać dalej. Przy stronie testowej z ok. 300 tys. znaków wyglądała tak:
[WebFetch note: this page’s text is 300404 characters long and the answer above covers only characters 0 to 100000; the final 200404 were not read — to read on, call WebFetch again with the same url and offset: 100000.]
Według listy zmian Claude Code ta notatka jest nowa. Wcześniej tekst powyżej 100 tys. znaków przepadał bez żadnej informacji.
Gorzej jest ze stronami o ciężkim kodzie. Jeśli treść poprzedza ponad megabajt skryptów, WebFetch nie zobaczy z niej ani zdania i nie dopisze notatki.
Stronę czyta przy tym mniejszy, pomocniczy model. Claude, z którym toczy się rozmowa, dostaje tylko jego odpowiedź na zadane pytanie.
Jak czyta ChatGPT
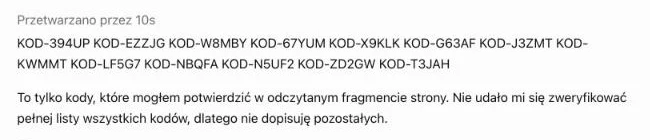
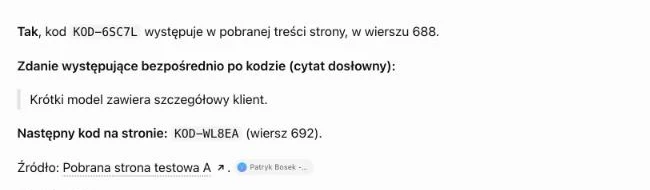
ChatGPT pobiera całą stronę, ale w trybie szybkim czyta po kolei ok. 25 tys. znaków. Dalszą część umie przeszukać po frazie. Zapytany o kod z końca strony testowej znalazł go od razu, a poproszony o wypisanie wszystkich kodów podał 13 ze 151.
Pytanie o konkretny nagłówek ChatGPT więc przejdzie, ale ogólna ocena strony obejmie tylko jej początek. Tryb myślący przeczytał całą stronę testową, doczytując ją kawałkami przez ok. 3 minuty.
Drugi limit dotyczy wagi strony. Stronę o wadze 3,9 MB ChatGPT przeczytał do końca, stronę 6 MB odrzucił we wszystkich trybach.
Audyt meta tagów na przykładzie wpisu blogowego
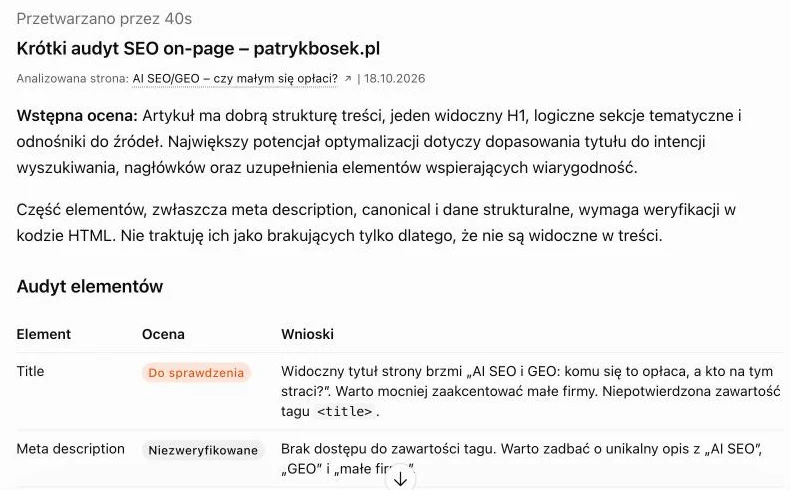
Oba narzędzia dostały prośbę o sprawdzenie title, meta description, canonical i danych strukturalnych we wpisie z tego bloga. Wszystkie te elementy są we wpisie poprawnie wdrożone.
- Claude odpisał, że nie może ich sprawdzić, bo dostał tylko widoczny tekst strony.
- ChatGPT poprawnie odczytał tytuł i nagłówki, a meta description, canonical i dane strukturalne oznaczył jako „niezweryfikowane”. Mimo to zaproponował nowy meta description.
Oba narzędzia zaznaczyły, czego nie widzą. Przy szybkim przeglądaniu takiego audytu łatwo jednak uznać, że czegoś brakuje, i dopisać drugi opis albo zainstalować kolejną wtyczkę do danych strukturalnych.
Opisy kategorii w dużych sklepach
Ten sam problem dotyczy kategorii znanych sklepów, które mają opis SEO pod listą produktów. Pozycję opisu zmierzono w kodzie stron, a wynik dla Claude sprawdzono testem na każdej z nich.
| Sklep | Tekst przed opisem | Kod przed opisem | Claude | ChatGPT |
|---|---|---|---|---|
| Morele.net | 57 tys. znaków | 1,2 MB | nie | tylko po frazie |
| Komputronik | 56 tys. znaków | 0,8 MB | nie | tylko po frazie |
| IKEA | 15 tys. znaków | 1,3 MB | nie | tak |
| Ceneo | 18 tys. znaków | 0,4 MB | tak | tak |
Nie ma tu jednej reguły. W IKEA opis stoi wysoko, więc ChatGPT go przeczyta, ale w kodzie poprzedza go ponad megabajt skryptów i Claude kończy czytanie wcześniej. W Komputroniku kod przed opisem mieści się w limicie, za to razem z adresami linków tekst ma ok. 149 tys. znaków, więc Claude do opisu też nie dociera.
Przeglądarka i curl zamiast linku w prompcie
Limit dotyczy narzędzia, które pobiera stronę z linku. Wystarczy więc dać modelowi stronę inną drogą.
Przeglądarka
Claude z rozszerzeniem Claude in Chrome otwiera stronę w zwykłej przeglądarce. Widzi treść doładowaną przez JavaScript i może przewinąć do opisu kategorii albo FAQ. W Claude Code przeglądarkę włącza się flagą claude --chrome albo poleceniem /chrome.
Bez wyraźnej instrukcji model i tak sięgnie po szybsze pobieranie z linku, dlatego przeglądarkę trzeba wymusić w prompcie, np.:
Otwórz stronę w przeglądarce (Claude in Chrome), nie używaj WebFetch. Przewiń do końca strony i dopiero wtedy oceń opis kategorii.
W ChatGPT tę samą rolę pełni tryb agenta. Analiza trwa dłużej, ale model widzi stronę tak jak klient sklepu.
curl
curl to narzędzie wiersza poleceń, które pobiera stronę dokładnie w takiej postaci, w jakiej wysyła ją serwer: z sekcją head, meta tagami, canonical i danymi strukturalnymi. ChatGPT w trybie myślącym sam po nie sięgnął. W opisie jego działań pojawił się krok „Pobrano pełny tekst przez curl” i dopiero po nim przeczytał całą stronę testową.
W Claude Code wystarczy poprosić:
Pobierz stronę przez curl do pliku, nie używaj WebFetch. Z pliku wyciągnij title, meta description, canonical, dane strukturalne i pełny tekst opisu kategorii.
Zapis do pliku ma znaczenie, bo model przeszukuje plik, zamiast wczytywać do rozmowy megabajty kodu. Do audytu meta tagów i danych strukturalnych to najpewniejsza metoda. Ma dwa ograniczenia: curl nie uruchamia JavaScriptu, więc treści doładowywanej skryptami w pliku nie będzie, a część serwisów blokuje takie zapytania. Wtedy zostaje przeglądarka.
Jeśli ocenić trzeba tylko tekst, wystarczy go skopiować i wkleić do czatu. Wklejona treść trafia do modelu w całości.
Podsumowanie
Model ocenia to, co dostał, a z linku dostaje zwykle tylko część strony. Przed wdrożeniem zaleceń z takiego audytu trzeba sprawdzić, czy model w ogóle widział treść, której dotyczą. Rzetelny audyt wymaga przeglądarki albo pobrania strony przez curl.
Wyniki opisują stan z października 2026 r. Narzędzia AI zmieniają się co kilka tygodni, więc limity mogą się przesunąć.