Wiele osób wciąż powtarza, że „ChatGPT korzysta z Binga”. To zdanie było bliskie prawdy w 2024 roku. Dziś opisuje tylko mały wycinek tego, co dzieje się, gdy ChatGPT szuka informacji w internecie.
W 2026 roku badacze zajmujący się wyszukiwarkami AI zajrzeli w dane, które ChatGPT przesyła do przeglądarki w trakcie pisania odpowiedzi. Okazało się, że ChatGPT ma własny indeks stron, nazywany Labrador, a obok niego pobiera wyniki z Google i korzysta z Binga.
Dla właściciela firmy albo brand managera to nie jest ciekawostka techniczna. Od tego, z którego źródła ChatGPT skorzysta, zależy, co powie o Twojej marce, Twoich produktach i Twojej konkurencji. Poniżej wyjaśnienie, jak to działa, co wiadomo o Labradorze i co warto sprawdzić na własnej stronie.
Dwa pojęcia, bez których trudno to zrozumieć
Indeks to katalog kopii stron internetowych zebranych wcześniej przez robota, czyli program, który automatycznie odwiedza strony i zapisuje ich treść (po angielsku crawler). Gdy wpisujesz zapytanie w Google, wyszukiwarka nie przeszukuje internetu na żywo, tylko swój katalog.
Wyszukiwanie w czasie rzeczywistym działa inaczej. Narzędzie wysyła zapytanie do zewnętrznej wyszukiwarki albo otwiera stronę dopiero w momencie, gdy jest potrzebna. Jest wolniejsze i zależne od cudzych danych.
ChatGPT odpowiada na dwa sposoby. Część odpowiedzi pochodzi z wiedzy, którą model zdobył podczas treningu. Gdy pytanie dotyczy rzeczy aktualnych, cen, produktów czy porównań, ChatGPT szuka w sieci. Rozbija wtedy pytanie użytkownika na kilka krótszych zapytań pomocniczych. Po angielsku nazywa się to query fan-out, a w polskich tekstach o SEO najczęściej po prostu fan-out. Na pytanie „jaki ekspres do kawy do małego biura” ChatGPT może w tle wyszukać na przykład „najlepsze ekspresy do biura 2026”, „ekspres przelewowy vs kolbowy biuro” i „ekspres do biura opinie”.
Pytanie brzmi więc: gdzie trafiają te zapytania pomocnicze?
Skąd wiadomo, że Labrador istnieje
Według Peec AI od 21 maja do 21 lipca 2026 roku w danych, które ChatGPT przesyła do przeglądarki podczas pisania odpowiedzi, widoczne było pole result_source, czyli „źródło wyniku”. Przyjmowało tylko cztery wartości: labrador, bright, oxylabs i serp. Trzy ostatnie to zewnętrzne firmy, które pobierają wyniki z Google. Pierwsza to system należący do OpenAI.
Badacze z kilku firm, przede wszystkim Peec AI i Resoneo, przeanalizowali tysiące takich odpowiedzi. Wynika z nich, że Labrador nie jest jednym indeksem, tylko rodziną indeksów tematycznych. Osobne zbiory obejmują m.in.:
- zwykłe strony internetowe,
- pliki PDF, filmy z YouTube, Wikipedię i publikacje naukowe,
- wiadomości (osobno z ostatniej doby, ostatnich 7 dni i starsze),
- firmy lokalne, finanse, prawo i medycynę,
- produkty i obrazy.
Do każdej strony indeks zapisuje jej pełną treść, datę ostatniego odwiedzenia przez robota i datę publikacji.
OpenAI nigdy nie potwierdziło nazwy „Labrador”. Potwierdziło za to, że buduje własny indeks:
- Nick Turley, szef ChatGPT, zeznał w procesie antymonopolowym przeciwko Google, że OpenAI rozwija własny indeks. Firma prosiła też Google o dostęp do jego wyników, ale dostała odmowę.
- W pomocy ChatGPT OpenAI opisuje wyszukiwanie offline, które korzysta z „zaindeksowanych i zapisanych w pamięci treści z sieci”.
- 15 października 2026 roku Cloudflare (firma obsługująca ruch na milionach stron) opublikowało wpis współtworzony z inżynierami OpenAI. Sygnały z około 1% sieci Cloudflare pomogły OpenAI odkryć i zaindeksować setki milionów nowych stron.
Jedno zastrzeżenie na start. Według Malte Landwehra z Peec AI OpenAI w połowie października 2026 roku zamknęło dostęp do szczegółowych danych, z których korzystali badacze. To, co wiadomo o Labradorze, jest więc obrazem z okresu maj–październik 2026 roku. Mechanizmy mogą się już zmieniać.
Trzy drogi, którymi informacje trafiają do ChatGPT
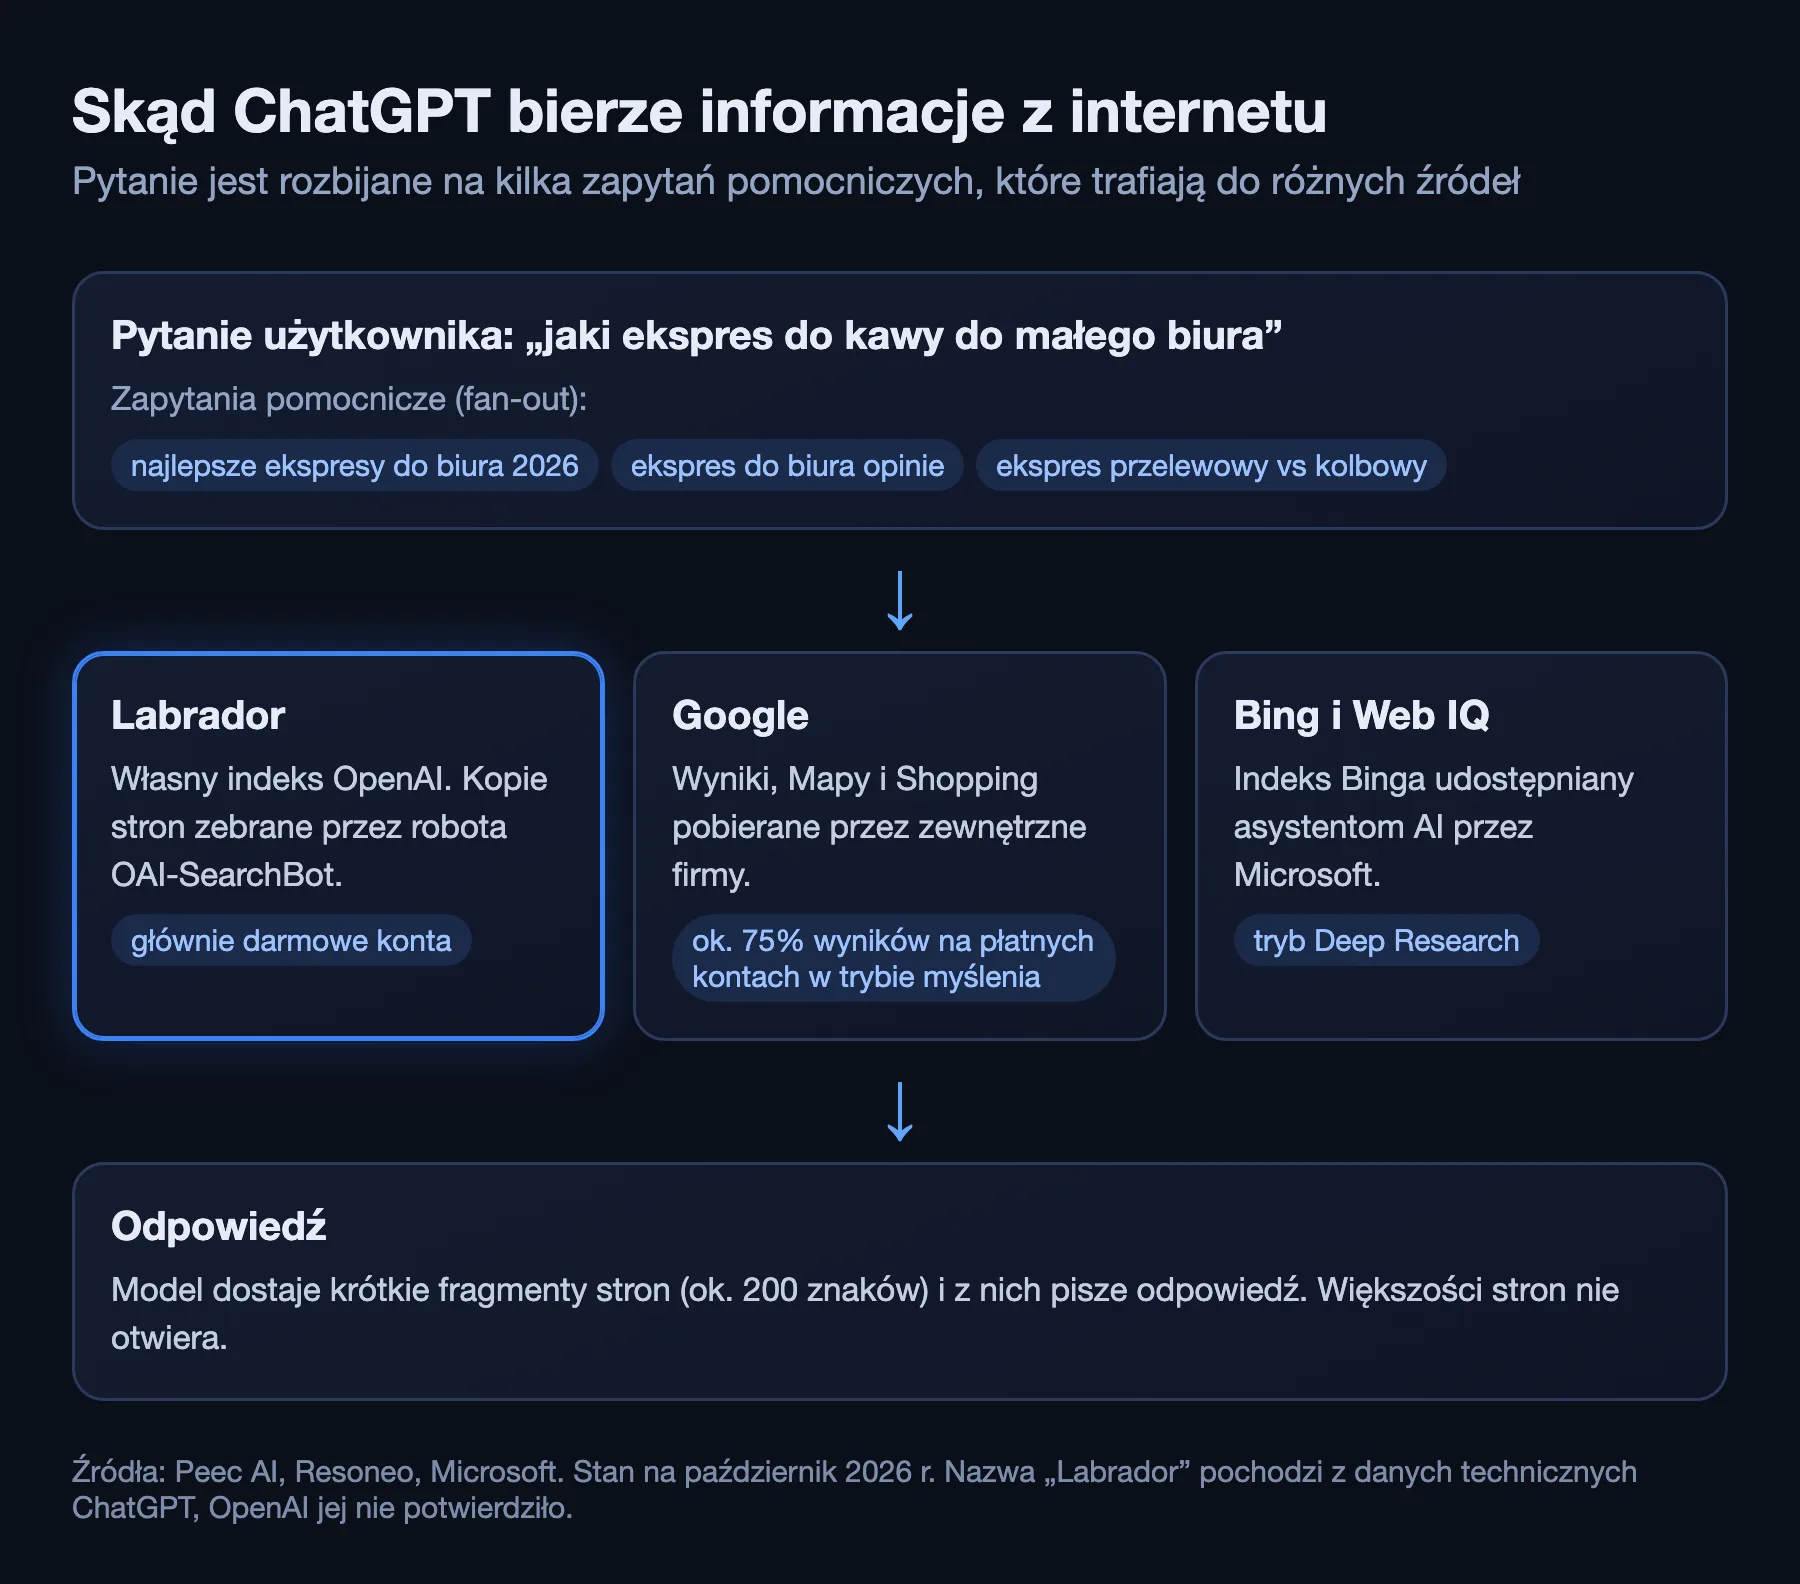
Gdy ChatGPT wyszukuje informacje, korzysta z trzech głównych źródeł.
1. Labrador, czyli własny indeks OpenAI. Strony trafiają do niego dzięki robotowi OAI-SearchBot. Indeks jest szybki, bo ChatGPT nie musi otwierać stron na żywo. Ma gotowe kopie i fragmenty tekstu.
2. Google, pobierany przez zewnętrzne firmy. Google nie udostępnia OpenAI swoich wyników, więc ChatGPT korzysta z firm, które automatycznie pobierają wyniki wyszukiwania. Taką praktykę nazywa się scrapingiem. W danych widać Bright Data, Oxylabs i trzeciego dostawcę oznaczonego jako „serp”. W ten sam sposób ChatGPT pobiera dane z Map Google i Google Shopping.
3. Bing i Microsoft Web IQ. Microsoft w czerwcu 2026 roku przedstawił Web IQ, wyszukiwarkę zbudowaną na indeksie Binga z myślą o asystentach AI. Według Microsoftu ta sama infrastruktura obsługuje Copilota i ChatGPT. Z badań Peec AI wynika też, że tryb Deep Research (głębokie wyszukiwanie, w którym ChatGPT przez kilka minut przygotowuje raport) korzysta z wyników Binga.
Do tego dochodzą źródła branżowe. Przy pytaniach o firmy lokalne ChatGPT sięga po dane z Yelpa, TripAdvisora i Map Google.
| Źródło | Kiedy jest używane | Co to oznacza dla firmy |
|---|---|---|
| Labrador | darmowe konta, szybkie odpowiedzi | liczy się, jak strona wygląda w indeksie OpenAI |
| płatne konta w trybie myślenia, produkty w Europie | pozycje w Google wciąż przekładają się na ChatGPT | |
| Bing | Deep Research | Bing Webmaster Tools nadal ma sens |
Darmowy i płatny ChatGPT widzą inny internet
To najmniej znany i jeden z najważniejszych wniosków z badań. Resoneo przeanalizowało 1249 odpowiedzi ChatGPT z lipca i sierpnia 2026 roku:
- Darmowe konta korzystały głównie z Labradora: 64% wyników w lipcu i ok. 75% w sierpniu, gdy darmowi użytkownicy dostali przycisk dłuższego myślenia.
- Płatne konta w trybie myślenia (ChatGPT dłużej analizuje pytanie przed odpowiedzią) w ok. 75% korzystały z wyników Google.
Chris Green w badaniu opisanym przez Search Engine Land zadał 1000 pytań do 10 razy każde. W 11,6% przypadków to samo pytanie trafiało przy kolejnym uruchomieniu do innego źródła. Gdy tak się działo, cytowane strony pokrywały się o ok. 45% słabiej niż przy powtórzeniach z tego samego źródła.
Wniosek dla marki: jeśli sprawdzasz, co ChatGPT mówi o Twojej firmie, na płatnym koncie, widzisz inną wersję niż większość klientów korzystających z darmowej. Jedno sprawdzenie niczego nie dowodzi. Trzeba patrzeć na powtarzalne wyniki.
ChatGPT rzadko otwiera Twoją stronę
Wiele osób wyobraża sobie, że ChatGPT „czyta” strony, które cytuje. Dane mówią coś innego. W badaniu Resoneo z ok. 58 tys. wyszukanych adresów ChatGPT faktycznie otworzył 759, i to prawie wyłącznie na płatnych kontach w trybie myślenia. W pozostałych przypadkach model pracował na krótkim fragmencie tekstu zapisanym w indeksie. Taki fragment nazywa się snippetem.
Snippet z Labradora ma ok. 200 znaków i zaczyna się od nagłówka H1 i pierwszych zdań treści strony, a nie od meta description (opisu, który przygotowuje się dla Google i który widać w wynikach wyszukiwania). Meta description jest pomijany. Jeśli nad nagłówkiem strona ma ścieżkę nawigacji, datę albo baner, część tych 200 znaków przepada na rzeczy bez znaczenia.
To samo badanie pokazało dwa inne ograniczenia:
- Dane strukturalne nie trafiają do modelu. Gdy ChatGPT pobiera stronę na prośbę użytkownika, kod JSON-LD jest usuwany, zanim treść trafi do modelu. JSON-LD to opis strony przygotowany dla wyszukiwarek, np. cena produktu czy ocena gwiazdkowa.
- Strony powyżej 4 MB nie są czytane wcale.
Do tego dochodzi JavaScript. Roboty OpenAI nie uruchamiają skryptów, więc treść, która pojawia się na stronie dopiero po ich załadowaniu, np. opinie albo tabela rozmiarów, dla ChatGPT nie istnieje.
Więcej o tym, ile treści z podanego linku czytają ChatGPT i Claude, we wpisie Link w prompcie to nie cała strona.
Indeks pamięta dłużej, niż się wydaje
Labrador działa jak pamięć podręczna (ang. cache) z bardzo długim terminem ważności. Z badań Resoneo wynika, że:
- kopia strony pobrana na prośbę użytkownika jest traktowana jako aktualna przez 30 minut, a potem nadal jest pokazywana, podczas gdy w tle pobierana jest nowa,
- te same kopie służą różnym użytkownikom i były wykorzystywane jeszcze po 91 dniach,
- znacznik noindex, czyli informacja dla wyszukiwarek, żeby nie pokazywały strony, nie zablokował zapisywania kopii.
Malte Landwehr z Peec AI opisał przypadki jeszcze dłuższej pamięci:
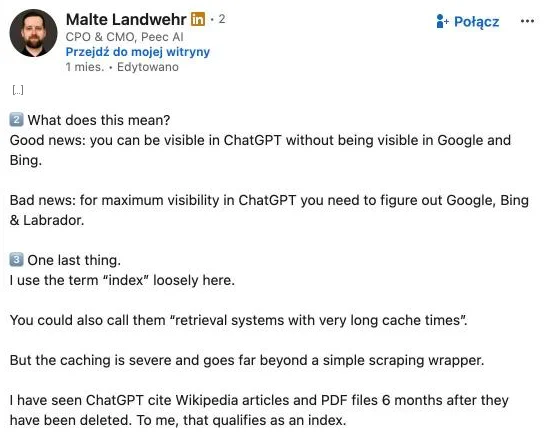
Dla firmy oznacza to, że stara cena, wycofany produkt albo nieaktualna oferta mogą żyć w odpowiedziach ChatGPT jeszcze długo po zmianie na stronie. Lepiej stronę zaktualizować albo przekierować na nową, niż ją po prostu usunąć.
Jak strona trafia do Labradora
W Google wystarczy zgłosić stronę w Google Search Console. OpenAI nie ma takiego narzędzia. Nie da się zgłosić adresu ani sprawdzić, czy strona jest w indeksie.
Z testów wiadomo tyle:
- Roboty OpenAI trafiają na strony przez linki. W teście Resoneo robot GPTBot odwiedził tego samego dnia wszystkie nowe strony, do których prowadziły linki, a żadnej z tych dostępnych tylko w mapie strony (pliku sitemap ze spisem adresów dla robotów).
- Odwiedzenie strony to jeszcze nie indeks. W domenie obserwowanej przez Resoneo przez 16 dni do indeksu nie trafiła żadna nowa strona.
- Cloudflare pomaga. Strony obsługiwane przez Cloudflare mogą być odkrywane szybciej dzięki opisanej wyżej współpracy. Szersze wdrożenie zapowiedziano na koniec 2026 roku.
Za dostęp do strony odpowiadają roboty OpenAI. Każdy ma inną rolę i każdego można osobno zablokować w pliku robots.txt (pliku z instrukcjami dla robotów, który leży w głównym katalogu strony).
| Robot | Do czego służy | Co się stanie po zablokowaniu |
|---|---|---|
| OAI-SearchBot | indeks do wyszukiwania w ChatGPT | strona znika z odpowiedzi |
| GPTBot | trening modeli | brak wpływu na wyszukiwanie |
| ChatGPT-User | wizyty na prośbę użytkownika | robots.txt może być pominięty |
| OAI-AdsBot | sprawdzanie stron z reklam | dotyczy tylko reklam |
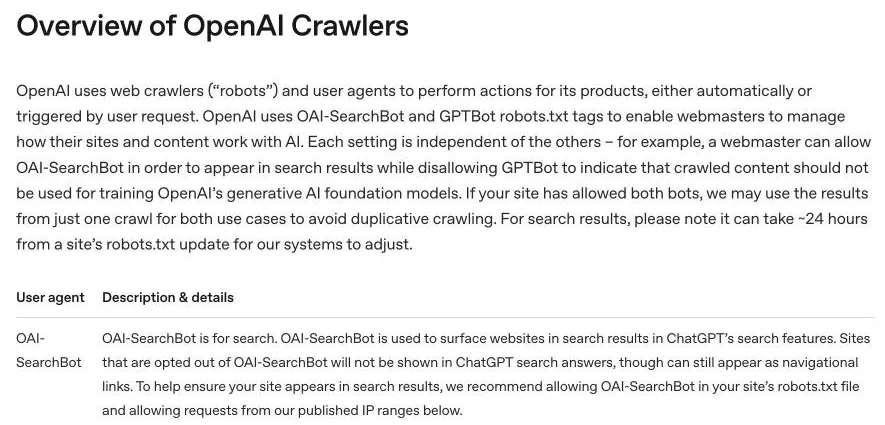
Częsty błąd to blokada, o której nikt nie wie. Cloudflare od lipca 2025 roku pyta każdą nową domenę, czy wpuścić roboty AI, a domyślnie ich nie wpuszcza. Firewalle hostingów też potrafią odrzucać ruch z nieznanych adresów. Warto raz sprawdzić to z osobą, która opiekuje się stroną.
Jak ChatGPT wybiera fragmenty do odpowiedzi
Strony nie trafiają do modelu w całości. System dzieli je na bloki tekstu (po angielsku chunks), ocenia każdy z nich osobno i do odpowiedzi przekazuje tylko te z najwyższą oceną.
Przez długi czas popularna była rada, żeby pisać bardzo krótkie, oderwane od siebie akapity, bo „AI czyta w kawałkach”. David Konitzny z Peec AI sprawdził na danych z ChatGPT, jak naprawdę wygląda ten podział. Granice bloków nie pokrywały się z akapitami ani sekcjami. Jeden blok obejmował tytuł, wstęp, nagłówek i pierwszą kartę oferty, inny zaczynał się w połowie odpowiedzi z FAQ. Liczyło się to, czy blok zawiera słowa i pojęcia z zapytania. Bloki, które obejmowały ponad połowę słów z zapytania, prawie trzy razy częściej dostawały najwyższą ocenę (61% wobec 23%).
Ten mechanizm łatwo pomylić z innym, opisanym we wpisie Link w prompcie to nie cała strona. Tam ChatGPT miał już otwartą stronę i przeszukiwał ją po konkretnej frazie, tak jak robi się to skrótem Ctrl+F. Peec AI opisuje to narzędzie jako komendę find: model wraca dokładnie do linii, w której znalazł szukane słowo, i czyta tekst od tego miejsca.
Różnica polega na tym, kto i kiedy wybiera tekst:
- Ocena bloków działa automatycznie, zanim model zobaczy stronę. System sam dzieli stronę i ocenia bloki pod kątem zapytania. Nie musi przy tym trafić w dokładne słowo, bo model oceniający bierze pod uwagę także znaczenie.
- Wyszukiwanie frazy uruchamia sam model, gdy czegoś mu brakuje w otwartej stronie. Szuka dokładnego ciągu znaków. Jeśli strona używa innego słowa, nie znajdzie nic.
Wspólny wniosek jest jeden. W obu przypadkach model widzi tylko wybrane fragmenty strony, a szansę na wybór mają te, w których padają słowa i pojęcia z pytania klienta. Dlatego warto nazywać rzeczy tak, jak nazywają je klienci, także w nagłówkach.
Dobrze działa też jedno konkretne zdanie z odpowiedzią na początku sekcji. W eksperymencie opisanym przez Peec AI firma OnBoard dodała krótką sekcję z najważniejszymi informacjami do jednej strony, a drugą zostawiła bez zmian. Wskaźnik cytowań zmienionej strony wzrósł o 61% w 6 tygodni, a strony bez zmian o ok. 7%.
Kilka innych ustaleń, które przydają się w praktyce:
- YouTube. ChatGPT nie ogląda filmów. W danych z ChatGPT dostaje tytuł, nazwę kanału, liczby wyświetleń i subskrypcji oraz pełny opis filmu, ale nie transkrypcję. Opis warto więc pisać jak stronę ofertową, z rozdziałami.
- Obrazy. ChatGPT ma osobny indeks zdjęć. Każde zdjęcie ma w nim ocenę jakości i opisy przygotowane z obrazu oraz z tekstu wokół niego.
- Język. 43% zapytań pomocniczych do pytań zadanych w innych językach niż angielski ChatGPT wysyła po angielsku. W przykładzie Peec AI na pytanie o najlepsze polskie portale aukcyjne model pomijał Allegro albo stawiał je nisko, a wyżej pokazywał eBay.
Każdy nowy model zmienia reguły
ChatGPT co kilka tygodni dostaje nowy model domyślny i za każdym razem zmienia się sposób wyszukiwania. Dwa przykłady z ostatnich miesięcy, z danych Peec AI:
- GPT-5.6 (od sierpnia 2026 r.) pobierał średnio ok. 24 źródła na pytanie zamiast ok. 12, a operator
site:, czyli wyszukiwanie wyłącznie na stronach jednej domeny, pojawiał się w 23% zapytań pomocniczych. Model częściej szukał informacji bezpośrednio na stronach marek. - GPT-6 (od 7 października 2026 r.) szuka rzadziej, ale dłuższymi zapytaniami, a wróciły porównania i rankingi typu „najlepsze X”. Model sześć razy częściej ostrzega, że ranking nie był niezależnie sprawdzony, i dwa razy częściej podważa liczby podawane przez samych producentów.
Zmiany dotykają też pomiaru. Między 8 a 15 października 2026 r. linki z ChatGPT przez błąd trafiały na strony bez oznaczenia utm_source=chatgpt.com, więc w analityce wyglądały jak wejścia bezpośrednie. OpenAI potwierdziło błąd i go poprawiło.
Wniosek: jednorazowy pomiar widoczności w ChatGPT starzeje się szybciej niż raport z Google. Potrzebny jest stały monitoring.
Czy Google i Bing przestają mieć znaczenie
Nie. Dane pokazują raczej, że trzeba myśleć o trzech kanałach naraz:
- Google nadal dostarcza ok. trzech czwartych wyników na płatnych kontach w trybie myślenia i produkty w Europie.
- Bing zasila Deep Research i usługę Web IQ.
- Labrador obsługuje większość szybkich odpowiedzi na darmowych kontach.
Te systemy oceniają strony inaczej. Najlepiej pokazuje to eksperyment Metehana Yeşilyurta z Peec AI. Opublikował on serwis z dziesiątkami tysięcy wygenerowanych statystyk, oznaczony jako eksperyment. Google szybko przestał go pokazywać, a ChatGPT przez kolejne 7 miesięcy cytował go i wysłał na niego ponad 10 tys. odwiedzin.
Malte Landwehr podsumował to tak: dobra wiadomość jest taka, że można być widocznym w ChatGPT bez widoczności w Google i Bingu. Zła, że do pełnej widoczności trzeba ogarnąć wszystkie trzy.
Co sprawdzić na swojej stronie
Większość punktów to praca jednorazowa, którą wykona osoba opiekująca się stroną.
- Dostęp dla robotów. W robots.txt robot OAI-SearchBot nie może być zablokowany. Trzeba też sprawdzić ustawienia Cloudflare i firewalla. Blokada GPTBot to osobna decyzja, która nie wpływa na wyszukiwanie.
- Początek treści. Nagłówek H1 i pierwsze 2–3 zdania powinny same w sobie mówić, czego dotyczy strona i dla kogo jest. Bez banerów i ozdobników nad nagłówkiem.
- Treść widoczna bez JavaScriptu. Ceny, opisy, opinie i FAQ powinny być w kodzie strony od razu, a nie doładowywane skryptem.
- Waga strony. Poniżej 4 MB kodu HTML.
- Linkowanie wewnętrzne. Nowe strony powinny mieć linki z innych podstron, a nie tylko wpis w mapie strony.
- Słowa klientów. W nagłówkach i pierwszych zdaniach sekcji te same określenia, których używają klienci w pytaniach.
- Aktualizacje zamiast usuwania. Nieaktualne strony lepiej przekierować albo zaktualizować.
- Logi serwera. Wizyty robotów OAI-SearchBot i ChatGPT-User pokazują, które podstrony ChatGPT faktycznie odwiedza.
- Bing Webmaster Tools. Strona powinna być poprawnie zaindeksowana w Bingu.
- Pomiar. Regularne sprawdzanie tych samych pytań, na darmowym i płatnym koncie, oraz pytanie „skąd o nas wiesz?” w formularzu kontaktowym albo po zakupie.
Czego jeszcze nie wiadomo
Uczciwie trzeba dodać kilka zastrzeżeń:
- nazwa „Labrador” pochodzi z danych technicznych, a nie od OpenAI,
- większość badań prowadzą firmy, które sprzedają narzędzia do monitorowania AI, na własnych zestawach pytań, a nie na rozmowach prawdziwych użytkowników,
- OpenAI zamknęło w październiku 2026 roku dostęp do danych, z których korzystali badacze, więc kolejne zmiany trudniej będzie śledzić,
- nie wiadomo, jak dokładnie Labrador ocenia jakość stron i dlaczego jedne trafiają do odpowiedzi częściej niż inne.
Z tego, co już wiadomo, wynika jednak sporo. ChatGPT nie jest nakładką na Binga, tylko korzysta z kilku źródeł naraz, a wybór zależy od rodzaju konta, trybu i tematu pytania. Labrador zapisuje krótkie fragmenty stron, pamięta je miesiącami i nie widzi tego, co ukryte w skryptach. Dla firm oznacza to powrót do podstaw: dostępna strona, jasny początek treści, aktualne informacje i obecność w źródłach, którym AI ufa.
Wpis opisuje stan z października 2026 r.
Źródła
- Peec AI: ChatGPT built its own search index
- Peec AI Research: badania o ChatGPT (Labrador, dostawcy wyników, Deep Research, GPT-5.6, język zapytań)
- Resoneo: ChatGPT retrieval
- Search Engine Land: ChatGPT citations change when hidden search pipelines switch
- Search Engine Land: ChatGPT drop in UTM tracking was a bug
- Cloudflare i OpenAI: discovery for the agentic web
- Cloudflare: domyślna blokada robotów AI (lipiec 2025)
- Search Engine Roundtable: OpenAI ChatGPT web cache
- Microsoft: Web IQ, grounding system for the agentic web
- OpenAI: Overview of OpenAI crawlers
- Courthouse News: zeznania Nicka Turleya
- Peec AI: How ChatGPT Deep Research reads your site
- Peec AI: How two teams run their own GEO experiments
- Peec AI: ChatGPT searches in English even when you don’t
- Peec AI: Publish stats, get cited
- Posty na LinkedIn: Malte Landwehr (indeks i cache, zamknięcie dostępu do danych), David Konitzny (bloki tekstu, YouTube, indeks obrazów, GPT-6, GPT-6 a rankingi)